神经表示模型(Neural Representation Models)
Ref: assets/2026-08-04/神经表示模型.pdf(谭忠,厦门大学,2025-08-03,80 页)
课程大纲:前馈神经网络 → 反向传播算法 → 卷积神经网络 → 模型的优化。
神经网络到底在干嘛(动机 · 输入输出 · 训练)
三个问题:为什么要造神经网络?它吃什么、吐什么?它是怎么学会的?
听了半天都不知道 是干嘛的😅。
动机:线性模型不够用
线性回归 ——它假设”输入每加一点,输出固定加一点”。这个假设在真实问题里基本不成立:
- 学习时间 → 是否及格:少学几乎不及格,多学快速提高,再学就封顶——S 形,不是直线;
- 面积 + 卧室数 → 房价:面积的效果取决于地段(同样 50㎡,市中心和郊区差一倍)——这是交互关系,一条平面表达不了;
- 像素 → 有没有哈基米:单个像素值和”哈基米”毫无直线关系,像素 255 什么也不是。
所以要一个能表达非线性的模型。神经网络就是为了这个造的。
一个神经元:一条线 + 一个弯
单个神经元: 是一条线,激活函数把它弯成 S 形。它能分两类,但只有一条边界、一个弯。
XOR 是最简的反例:
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
四个点,画一条直线怎么都分不开——这就是 Minsky 说的感知器”异或缺陷”。加一层隐藏层后,网络先把输入变成新特征 (比如”两个都大吗?""两个都小吗?”),在新空间里四个点就线性可分,输出层再画一条线搞定。
隐藏层 = 自动把空间掰弯,再画线。
关于直接学原始输入
“直接学”= 只做一次线性 + 一次弯曲,表达能力就一条边界。而真实任务的模式藏得太深:判断哈基米,原始输入是几十万个像素,你得先找边缘 → 再找眼睛耳朵 → 再组合成”这是哈基米”。这一层层的模式,靠一次变换翻不出来。
所以网络的做法是:每一层都把输入重新表示成一组更好用的特征,最后一层只做一件最简单的事——加权求和。层数越多,前面的层越像”自动特征提取器”。这跟读文章判断情绪一样:你不能用一条公式把十万个字映射成”开心/难过”,得先分词 → 词义 → 句义 → 文义,逐级抽象。这就是”神经表示”——网络内部每一层都在生成一种表示,输出只是把表示翻译成答案。
输入与输出
- 训练:给网络看 1000 套房子的数据——面积、卧室(输入)和真实成交价(输出),两边都知道,否则没法训练;
- 推理:来一套没卖过的新房子,只有输入,输出价格是模型给的答案——这就是模型的价值。
输出长什么样,由任务定:
| 任务 | 输出 | 用途 |
|---|---|---|
| 预测房价 | 一个实数 | 直接当价格 |
| 判断哈基米/大狗 | 两个概率(和为 1) | 取大的当类别 |
| 压缩图片(自编码器) | 低维向量 | 当作特征存下来 |
训练循环:四步,重复几万次
每看一批数据就做一遍:
- 前向:输入穿过各层,算出预测 ;
- 损失: 和真实 差多少,比如 ;
- 反向:把误差从输出层往回传,算出每个权重该往哪调、调多少(链式法则,这就是反向传播);
- 更新:,让损失变小一点。
以下是手搓数据。
极简网络:,目标 ;,。初始 ,学习率 。
| 步骤 | 计算 | 结果 |
|---|---|---|
| 前向 | 预测 0.4 | |
| 损失 | 2.56 | |
| 反向 | ; | 两个梯度 |
| 更新 | ; | 权重变大 |
再前向一次:,损失 ✓ 变好了。重复几百轮,,权重稳定,训练结束。
注意 的梯度是一路乘回去的()——这就是为什么激活函数的导数很重要:ReLU 正半轴导数为 1,梯度传得动;Sigmoid 饱和区导数趋近 0,深层网络就”梯度消失”。
第一章 前馈神经网络(Feedforward Neural Network)
神经元模型
一个神经元接收 维输入 ,加权求和得到净输入(Net Input):
其中 是权重向量, 是偏置。净输入经过非线性激活函数(Activation Function) 得到活性值:
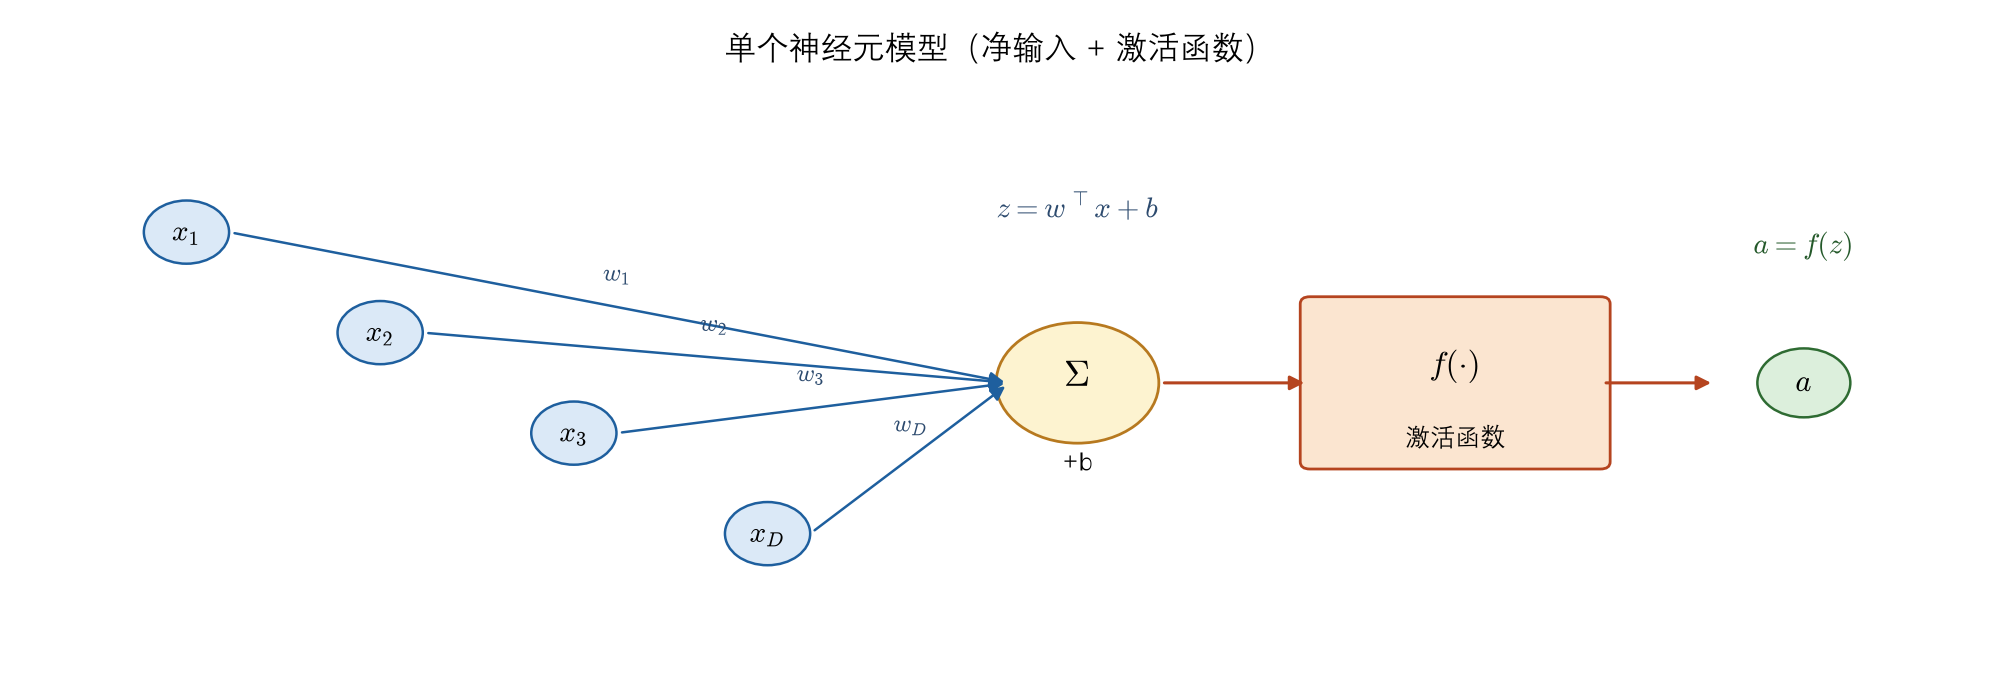
激活函数应满足:① 连续可导(允许少数点不可导)的非线性函数;② 形式简单、计算高效;③ 导函数值域适中,过大过小都会影响训练效率与稳定性。
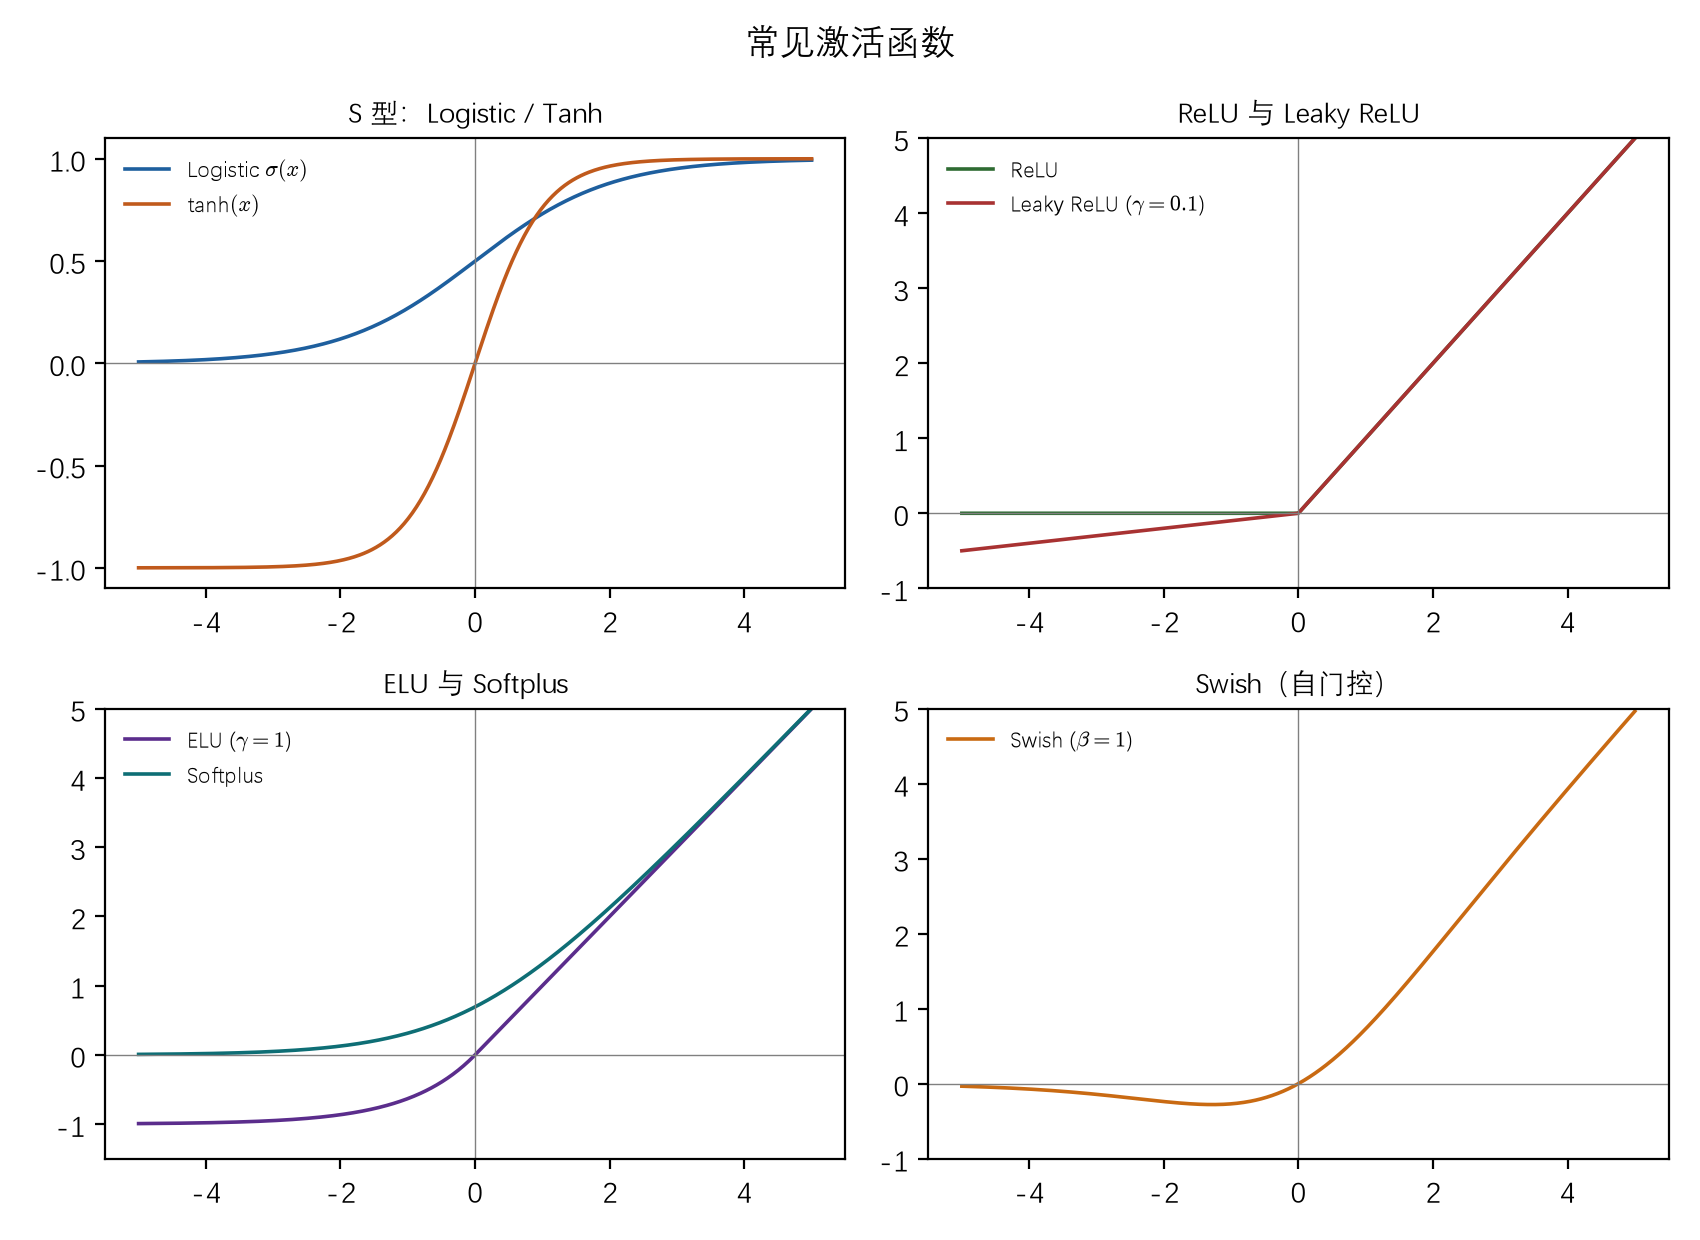
常见激活函数
| 函数 | 公式 | 特点 |
|---|---|---|
| Logistic | 值域 ,两端饱和 | |
| Tanh | 值域 ,是放大平移的 Logistic | |
| ReLU | 左饱和, 导数为 1,缓解梯度消失;但非零中心化、有 Dying ReLU 问题 | |
| Leaky ReLU | 保留小梯度 (如 0.01),避免神经元”死亡” | |
| PReLU | 同上,但 可学习 | 不同神经元可有不同参数; 退化为 ReLU |
| ELU | 时 ; 时 | 近似零中心化, 控制饱和曲线 |
| Softplus | ReLU 的平滑版,导数为 Logistic;无稀疏激活性 | |
| Swish | 自门控(Self-Gated), 可学习; 接近 1 开门、接近 0 关门 |
Dying ReLU
一次不恰当的参数更新后,某 ReLU 神经元在全部训练数据上都不再被激活,其梯度永远为 0 → 神经元永久死亡。Leaky ReLU / PReLU 是常用对策。
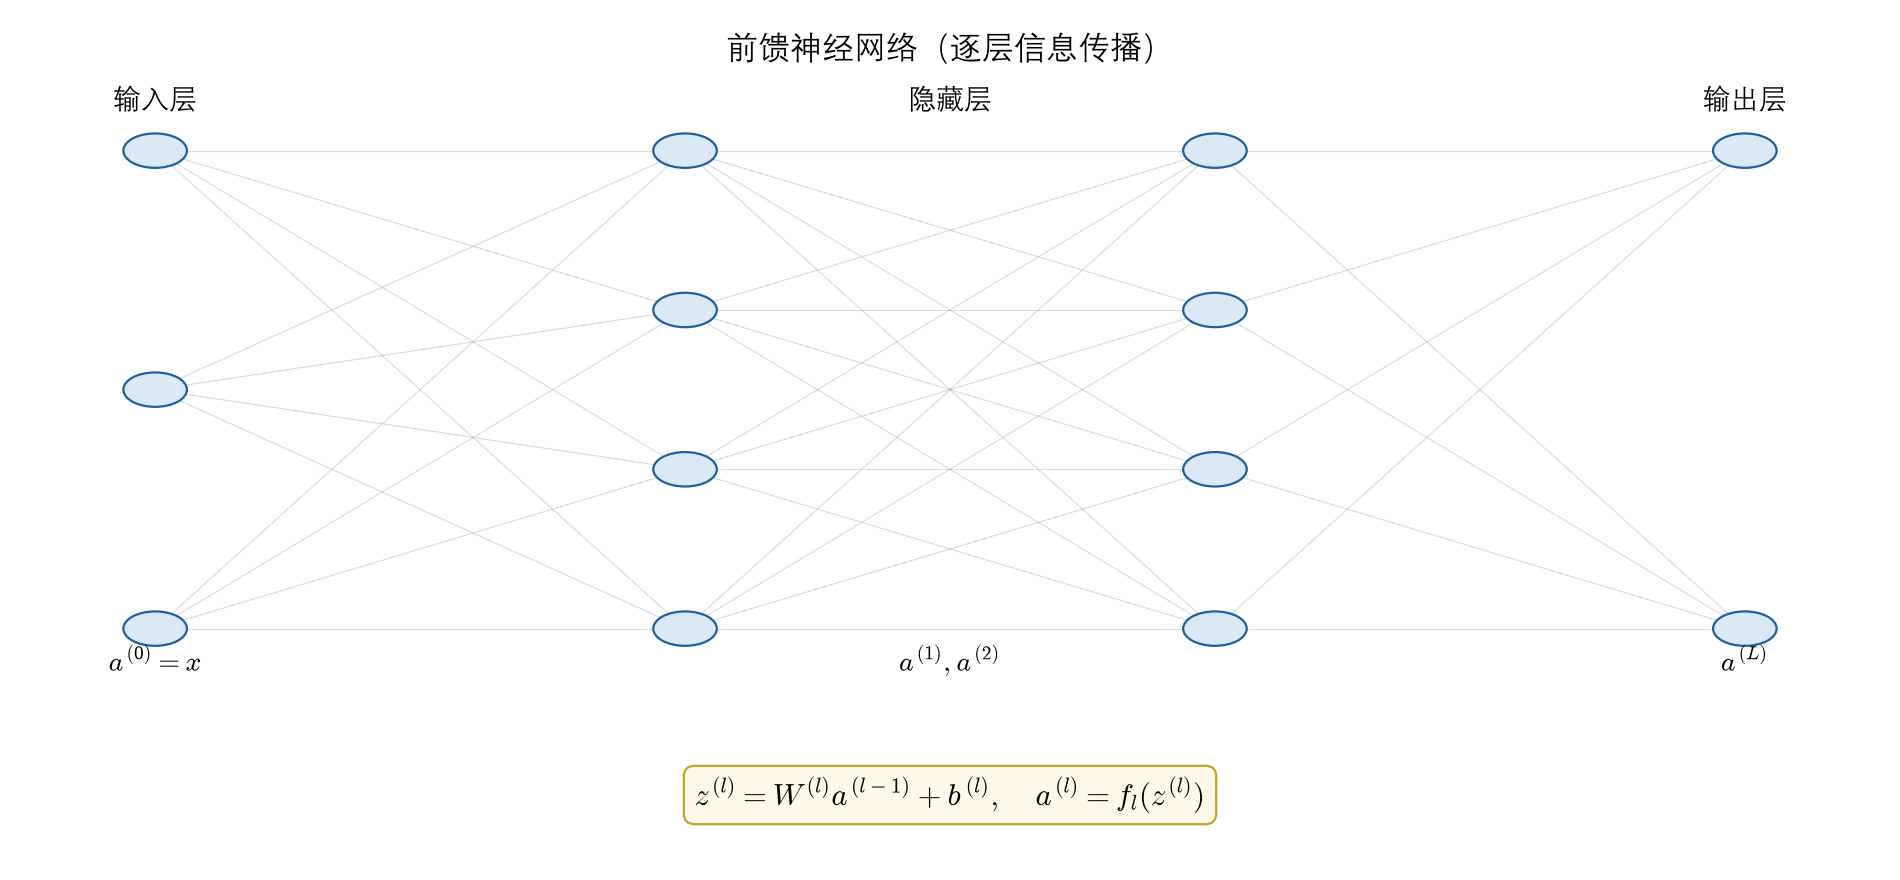
前向传播
记号: 网络层数;、 第 层权重与偏置; 净输入; 活性值。
令 ,逐层传播:
每层 = 一个仿射变换(Affine Transformation)+ 一个非线性变换。整个网络是复合函数 :
通用近似定理(Universal Approximation Theorem)
对 有界闭集上的任意连续函数 ,存在足够大的 与参数 ,使得
即:线性输出层 + 至少一个使用”挤压”型激活(Sigmoid 类,ReLU 也适用)的隐藏层 + 足够多神经元,可任意精度逼近连续函数。
局限
定理只说明”存在”这样的网络,不告诉怎么找到它、是否最优;真实映射未知,靠经验风险最小化 + 正则化学习。能力越强越容易在训练集上过拟合。
第二章 反向传播算法(BackPropagation)
目标:对每个样本计算损失 关于第 层参数 的梯度。核心是误差项(Error Term):
误差项反映第 层神经元对最终损失的敏感程度,解决了贡献度分配问题(Credit Assignment Problem, CAP)。
误差项的反向递推
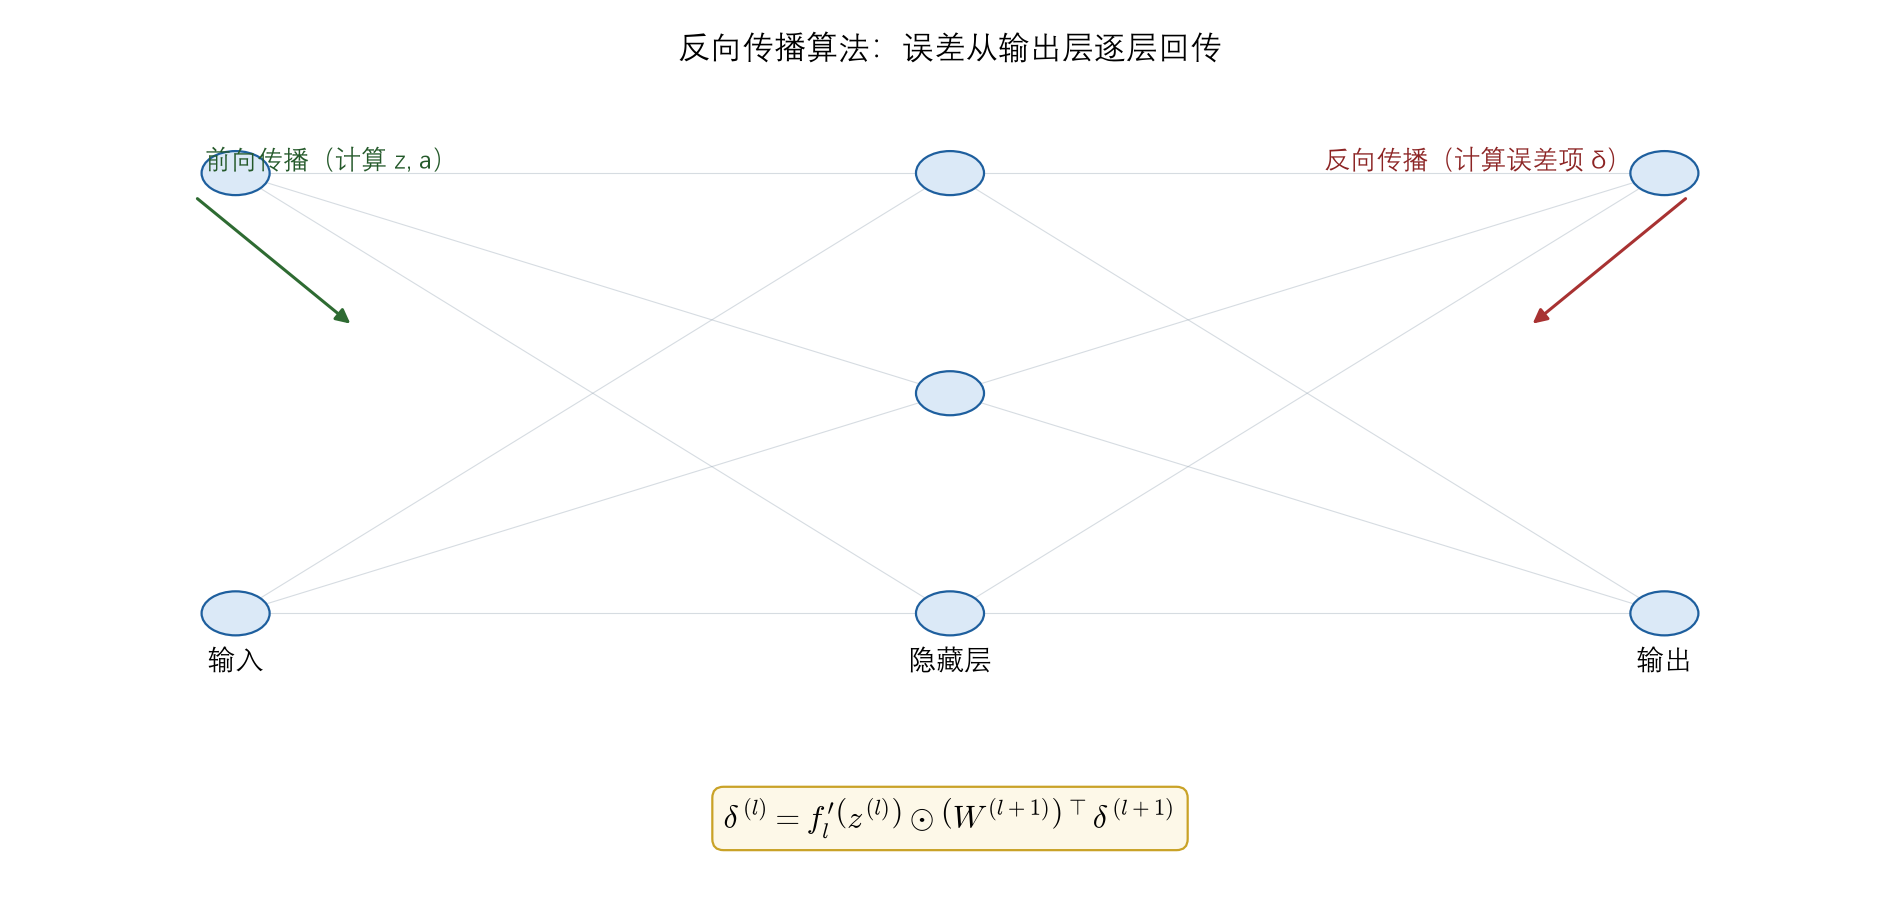
其中 为逐元素乘。含义:第 层某神经元的误差 = 所有与其相连的 层神经元误差的加权和,再乘该神经元激活函数的梯度。
参数梯度
即权重梯度是误差项 与上一层活性值 的外积;偏置梯度就是误差项本身。
BP 三步训练流程
- 前馈:逐层计算净输入 与活性值 直到最后一层;
- 反向:从输出层往回计算每层误差项 ;
- 更新:用上面两个公式求参数梯度,更新 。
第三章 卷积神经网络(CNN)
为什么需要卷积
图像是 3 维形状(高 × 宽 × 通道),空间上邻近像素相似、RGB 通道间关联密切。全连接层忽视形状,把所有输入当同一维度处理;卷积层保持形状,能利用空间信息。
CNN = 用层搭积木:新增卷积层(Convolution)与池化层(Pooling)。典型连接 Convolution - ReLU - (Pooling)(池化可省略),靠近输出端仍用 Affine - ReLU,最后一层用 Affine - Softmax。
卷积运算
一维卷积(信号延迟累积):滤波器(Filter)/卷积核(Kernel),长度为 :
例:衰减率 时,。
二维卷积(图像):图像 ,滤波器 ():
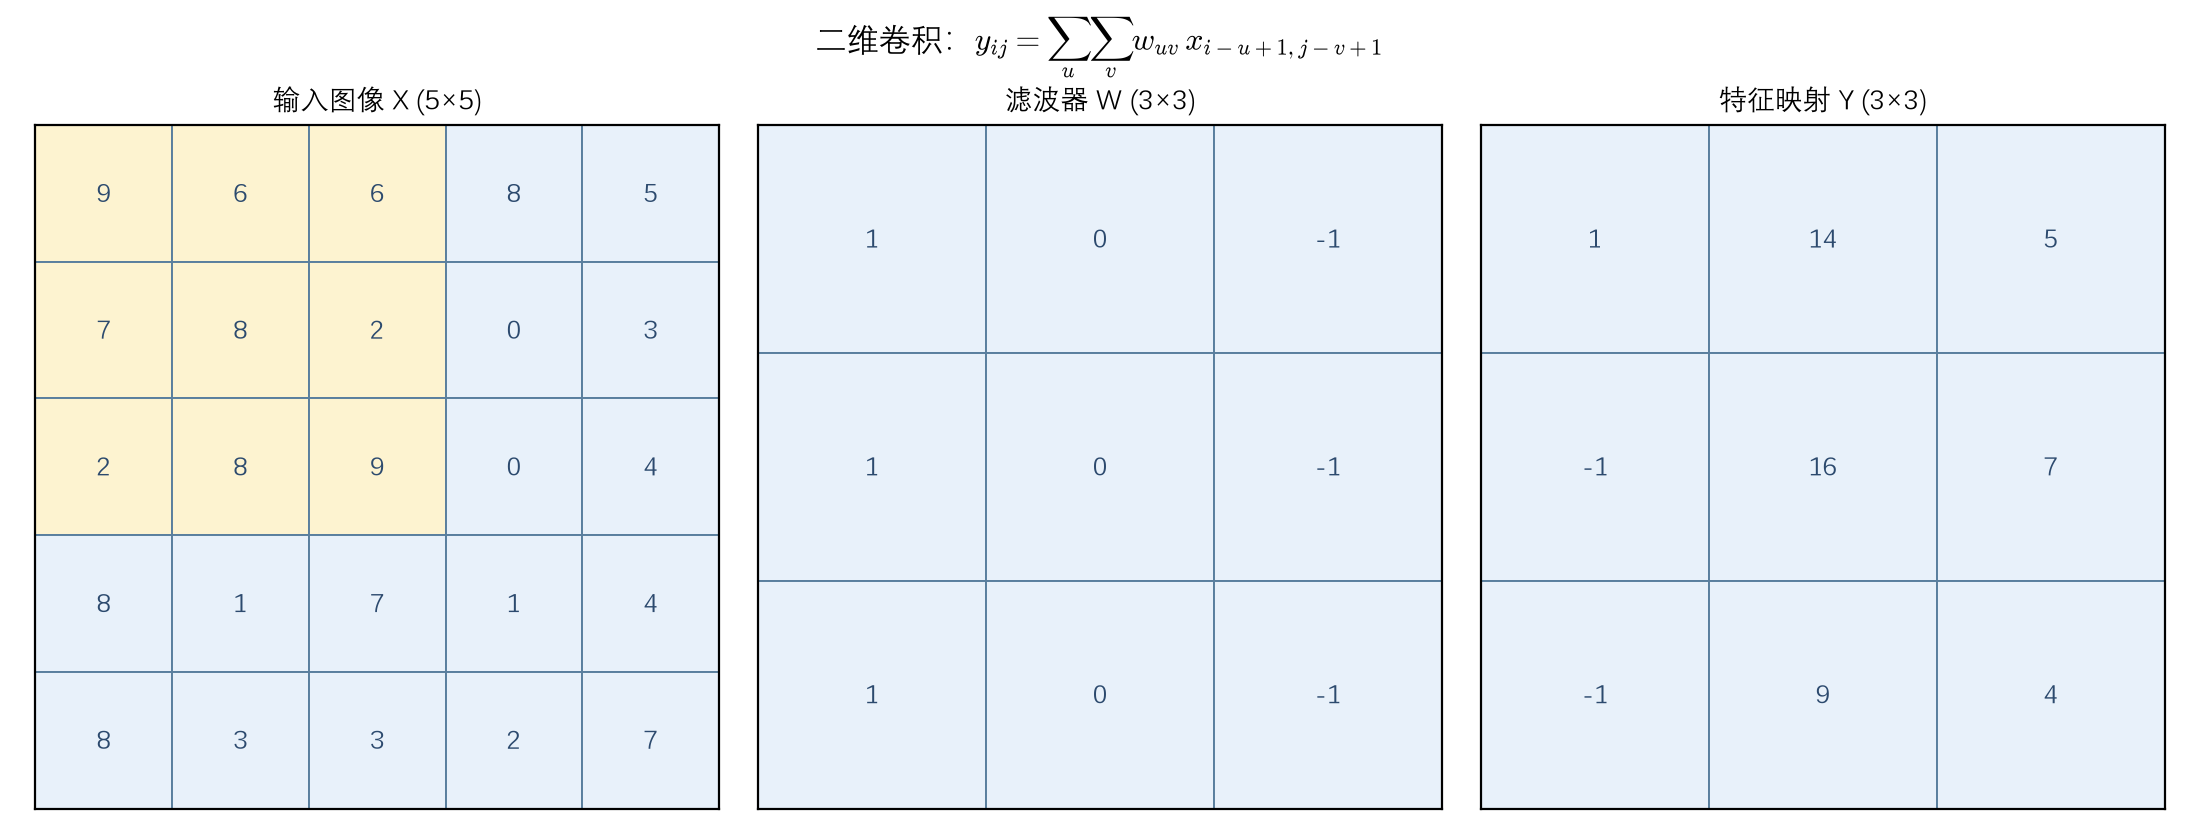
填充(padding):卷积前在输入周围补固定值(如 0),控制输出尺寸、保留边缘信息。
步幅(stride):滤波器窗口每次移动的间隔;步幅 2 时窗口间隔 2 个元素。
3 维卷积:输入有多个通道时,各通道分别卷积再相加,输出特征图(Feature Map)沿通道方向增多。
特征映射与常用滤波器
图像卷积后的结果叫特征映射(Feature Map)。常用滤波器:高斯滤波器(平滑去噪)、边缘提取滤波器等。
池化层(Pooling)
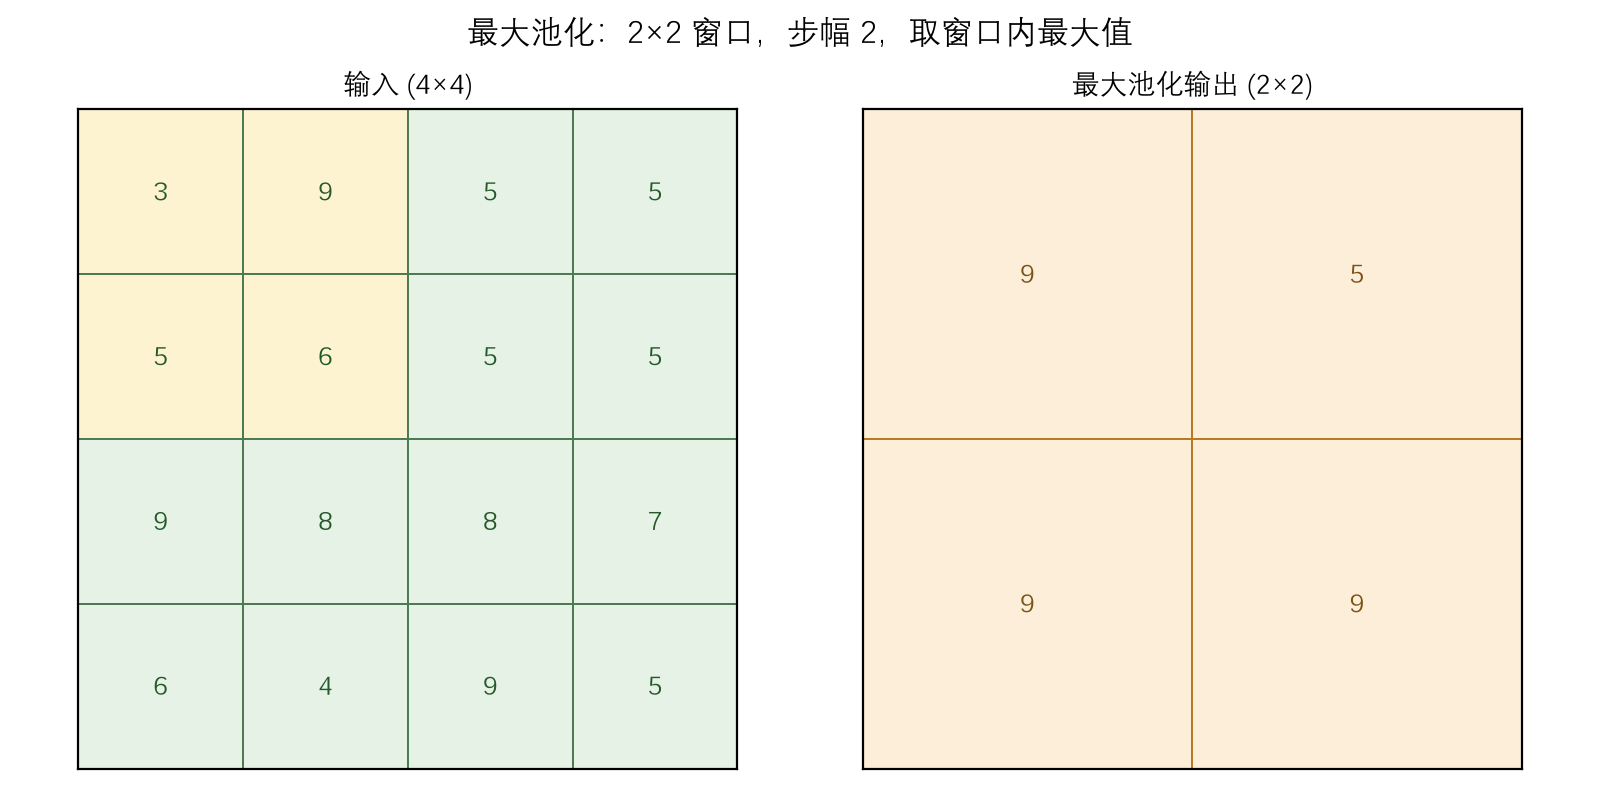
- 最大池化:取窗口内最大值(图像识别领域主流);平均池化:取窗口均值;
- 一般窗口大小与步幅相同(如 2×2 配步幅 2);
- 三个特征:没有可学习参数;通道数不变(按通道独立计算);对微小位移鲁棒(吸收输入的小偏差)。
第四章 模型的优化
目标:最小化经验风险
梯度下降与 SGD
一阶泰勒展开 ⟹ 沿负梯度方向下降最快:
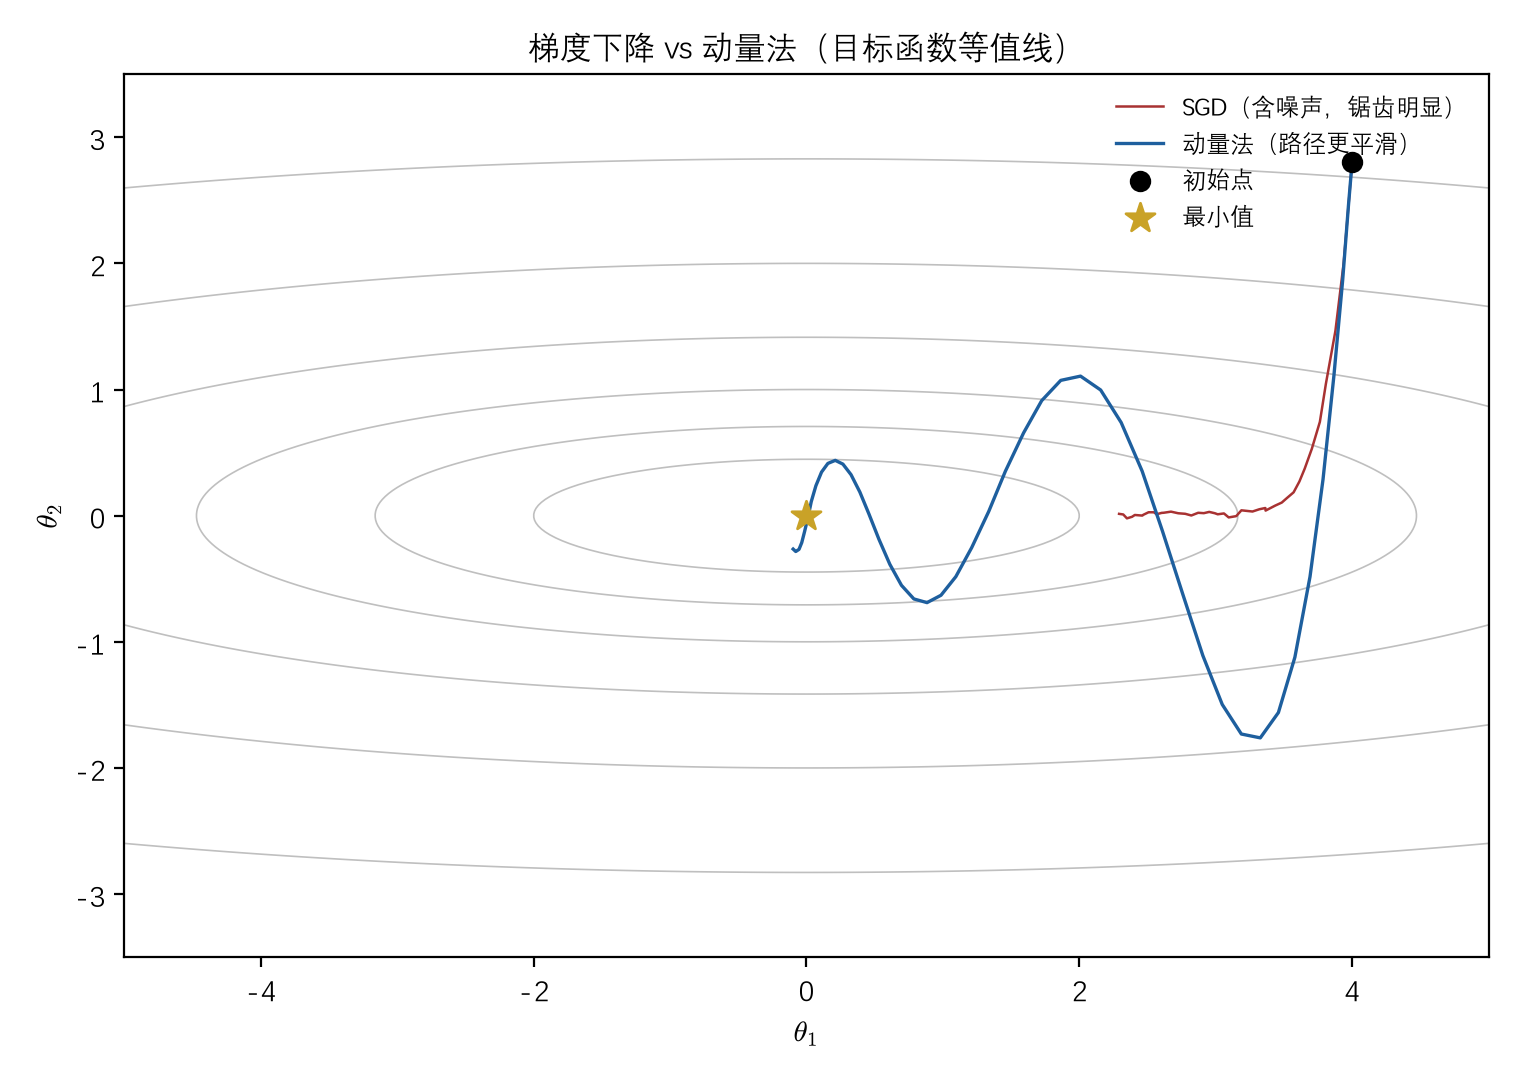
- 目标函数为凸函数时,梯度下降收敛到全局最优;
- 全批量梯度()代价太高 → mini-batch SGD:每轮随机采大小为 的子集,用 近似 (无偏估计):
- 收敛充分条件:, ⟹ 学习率要随迭代递减;目标函数长期不变时,可降到原来的 。
动量法(Momentum)
控制历史梯度衰减(实践常用 0.5 / 0.9 / 0.99)。克服了 Hessian 病态(poor conditioning)和随机梯度方差带来的不稳定。
Nesterov 动量:梯度在”加了当前速度之后”的位置计算(即 处),相当于提前探测、校正更新方向。
自适应学习率
| 算法 | 核心思想 | 参数更新 | 注意点 |
|---|---|---|---|
| AdaGrad | 每个参数用历史梯度平方和调学习率 | 不用停留鞍点;但学习率过早过快衰减 | |
| RMSprop | 历史均值 + 当前梯度平方 | 同 AdaGrad 形式, 用指数加权 | 推荐 ;缓解 AdaGrad 问题 |
| AdaDelta | 再用参数更新值的平方调学习率 | 无需人工学习率;多两个超参 | |
| Adam | 一阶矩(动量)+ 二阶矩(自适应率)+ 偏差修正 | 推荐 ;对超参不敏感、实践效果好 |
其中 (AdaGrad);RMSprop/Adam 用指数加权平均;Adam 的偏差修正 、。